Amazonのアソシエイトとして、当ブログは適格販売により収入を得ています。
記事の内容は以下のシステムでテストされています。
Ubuntu26.04.1LTS
Intel Core Ultra5 250K Plus
メインメモリ96GB(4800MT/s)
Intel Arc B580(12GB)
LLM
Qwen3.8-Flash-Next-GSQ-RCO-IQ3_S(83.6GB)
アウトランってなんぞ?
アウトランとは、大昔にSEGAがリリースしたドライブゲームです。
今回は、XeStrataの設定やpiのログの日本語化など、AIエージェント環境のちょっとした最適化のテストとして、アウトランを作らせてみました。
実際のところ題材はなんでも良かったのですが、見栄えが良い方がよかろうかと考えた次第です。
Arc B580でのXeStrataの設定
VRAM12GBだと、設定値しだいでVRAMに乗せられるエキスパート層の数が変わってきます。
もちろんたくさん乗った方が良いですよね。
ということで、VRAMの空き容量をなんとかかせいでいきます。
そこでまずひとつめ。
画面出力をArc B580から取るのをやめ、「Core Ultra5 250KPuls」の内蔵GPUから取ることにしました。
それからふたつめ、VRAMの専有設定の見直しです。
XeStrataの起動ログが、
Settings (xestrata-iq3_s.json): --expert-cache auto --prefill auto --spec 4 --spec-min-p 0.5
    --max-context 196608 --kv int8 --kv-resident 65535 --vision --vram-reserve-mib 700 --pool-workers 11
    --prefill-cpu-share 0.81 --vram-free-mib 11285; server 127.0.0.1:8095
となっていましたが、「–vram-reserve-mib 700」この部分を見直しました。
Xestrataのセットアップの時、画像認識の設定を「yes」にすると、この数値は自動的に「700」に設定されます。が、VRAM24GB以下のシステムだと画像認識はCPUになるようです。
だとしたら、「700MiB」もVRAMを開けておくのはムダなので、この数値を最低値の「300」に変更します。
そしてみっつめ。
コンテキストを最大の「262144」にしていましたが、速度とエージェントの目的遂行能力のバランスをとって「196608」に変更しました。
もっとVRAMがあれば、こんな小細工をしなくて済むんですが仕方ありません。
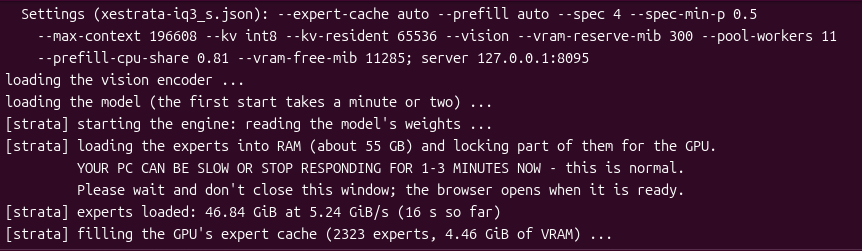
以前の記事の「42」とはえらい違いです。
piに表示されるログを、別のターミナルで日本語表示
エージェントは(というか「Qwen3.8」は)基本的には英語で思考します。
これを無理やり日本語にすることもできるらしいのですが、推論性能が低下するとか。
ただでさえ限られたリソースの中で動作させているので、性能低下は避けたいですよね。
そもそもQwenは日本語がイマイチです。
自分の環境はメインメモリが96GBと豊富なのでXeStrataを動かしてもまだかなり余裕があります。
そこで、
このモデルをllama.cppを使って、piのログを日本語に翻訳することにしました。
つまり、同時に2つの推論エンジンを動かすわけです。
もちろん別々のターミナルで動作させます。
とはいえ、Arc B580はXeStrataで目一杯使っています。
内蔵GPUはアウトランのテスト動作で使用する予定なので、残るはCPUしかありません。
幸い「Core Ultra5 250KPuls」はコア数がたくさんあるので、そのうちいくつかを「pfnet/plamo-3-translate-0.8b」に割り当てます。
taskset -c 12-17 $HOME/install/llama.cpp_build/llama.cpp/build-cpu/bin/llama-server \
  -m /run/media/test/semi_4TB/99_LLMモデル/quantize/plamo-3-translate-GGUF/plamo-3-translate-0.8b-Q4_K_M.gguf \
  -c 4196 \
  --parallel 1 \
  -fa on \
  -b 2048 -ub 2048 \
  -t 6 -tb 6 \
  -ctk q8_0 -ctv q4_0 \
  --host 127.0.0.1 \
  --port 8096 \
  --jinja
こんな感じでllama.cppを起動。
CPUコアの「0〜11」はxestrataが専有しているので、残りの「taskset -c 12-17」をllama.cppに割当て。
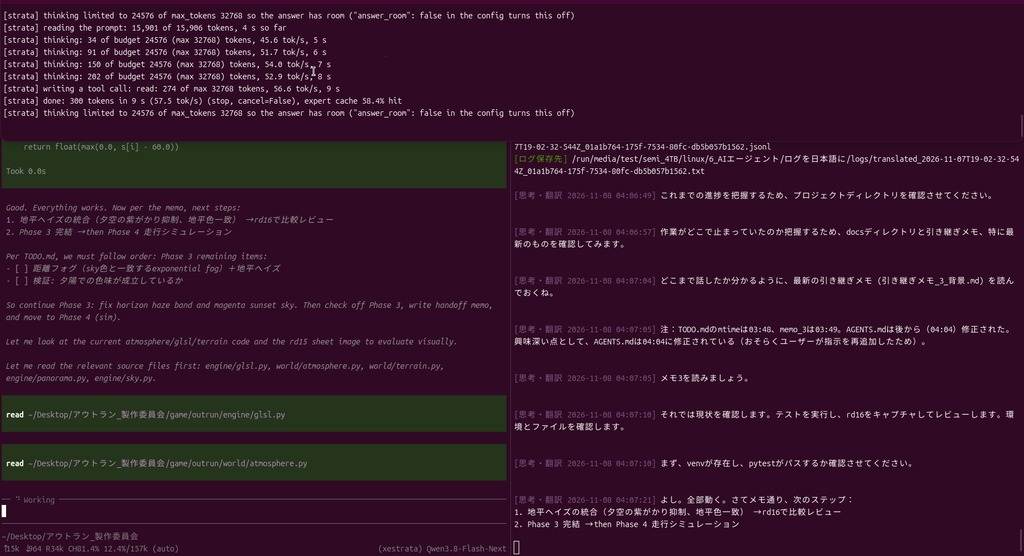
そうしたら次は、以下のpythonスクリプトを別のターミナルで起動して、piの最新のセッションログを読み取り、「plamo-3-translate-0.8b」で日本語訳してもらいます。
# /// script
# requires-python = ">=3.11"
# dependencies = [
#     "httpx",
# ]
# ///

import os
import sys
import time
import json
import re
import datetime
import httpx
from pathlib import Path

API_URL = "http://127.0.0.1:8096/v1/chat/completions"

# 翻訳ログの保存先フォルダ(カレントディレクトリ直下の logs/)
LOG_DIR = Path("logs")

def get_latest_session_file() -> Path | None:
    """Piのセッションディレクトリから最新のJSONLファイルを探索"""
    search_paths = [
        Path.home() / ".pi" / "agent" / "sessions",
        Path.home() / ".pi" / "sessions",
        Path.cwd() / ".pi" / "sessions",
    ]
    files = []
    for base in search_paths:
        if base.exists():
            files.extend(base.glob("**/*.jsonl"))
            files.extend(base.glob("**/*.json"))
            files.extend(base.glob("**/*.json*"))

    if not files:
        return None
    return max(files, key=lambda f: f.stat().st_mtime)

def translate_with_llm(client: httpx.Client, text: str) -> str:
    """Plamo-3-translateで翻訳"""
    payload = {
        "messages": [
            {"role": "user", "content": text}
        ],
        "temperature": 0.0,
        "max_tokens": 512,
        "stream": False
    }

    try:
        response = client.post(API_URL, json=payload, timeout=20.0)
        if response.status_code == 200:
            data = response.json()
            return data["choices"][0]["message"]["content"].strip()
        else:
            print(f"\033[31m[APIエラー {response.status_code}]\033[0m {response.text}", flush=True)
            return text
    except Exception as e:
        print(f"\033[31m[通信エラー]\033[0m {e}", flush=True)
        return text

def extract_thinking_texts(data: dict) -> list[str]:
    """JSONエントリーから思考(Thinking)テキストを抽出"""
    texts = []

    if "thinking" in data and isinstance(data["thinking"], str):
        texts.append(data["thinking"].strip())

    msg = data.get("message", data)
    content = msg.get("content", [])

    if isinstance(content, list):
        for part in content:
            if isinstance(part, dict):
                if part.get("type") in ("thinking", "reasoning") and part.get("thinking"):
                    texts.append(part["thinking"].strip())
    elif isinstance(content, str) and msg.get("role") == "assistant":
        think_matches = re.findall(r"<think>(.*?)</think>", content, flags=re.DOTALL)
        for m in think_matches:
            texts.append(m.strip())

    return texts

def write_and_display(log_file_fp, text: str):
    """画面にカラー表示し、同時にtxtファイルにタイムスタンプ付きで保存"""
    now_str = datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S")

    # 1. ターミナル表示(視認性の高いカラー付き)
    print(f"\n\033[35m[思考・翻訳 {now_str}]\033[0m {text}\n", flush=True)

    # 2. テキストファイル保存(プレーンテキスト)
    if log_file_fp:
        log_file_fp.write(f"[{now_str}] {text}\n\n")
        log_file_fp.flush()

def watch_sessions():
    """セッションファイルを監視し、翻訳結果を画面表示&txt保存"""
    LOG_DIR.mkdir(parents=True, exist_ok=True)

    current_file = get_latest_session_file()
    current_fp = None
    log_fp = None

    with httpx.Client() as client:
        if current_file and current_file.exists():
            print(f"\033[36m[監視開始]\033[0m {current_file}", flush=True)
            current_fp = open(current_file, "r", encoding="utf-8", errors="ignore")
            current_fp.seek(0, os.SEEK_END)

            # 対応するテキストファイルを作成/オープン
            out_txt_name = LOG_DIR / f"translated_{current_file.stem}.txt"
            log_fp = open(out_txt_name, "a", encoding="utf-8")
            print(f"\033[32m[ログ保存先]\033[0m {out_txt_name.resolve()}", flush=True)
        else:
            print("\033[33m[待機中]\033[0m Piのセッションファイルを探索中...", flush=True)

        last_check_time = time.time()

        while True:
            now = time.time()
            if now - last_check_time > 1.0:
                last_check_time = now
                latest = get_latest_session_file()

                # 新規セッションが作られたら切り替え
                if latest and (current_file is None or latest.resolve() != current_file.resolve()):
                    if current_fp:
                        current_fp.close()
                    if log_fp:
                        log_fp.close()

                    current_file = latest
                    out_txt_name = LOG_DIR / f"translated_{current_file.stem}.txt"

                    print(f"\n\033[32m[新規セッション検出・切り替え]\033[0m {current_file}", flush=True)
                    print(f"\033[32m[ログ保存先]\033[0m {out_txt_name.resolve()}", flush=True)

                    current_fp = open(current_file, "r", encoding="utf-8", errors="ignore")
                    current_fp.seek(0, os.SEEK_SET)
                    log_fp = open(out_txt_name, "a", encoding="utf-8")

            if current_fp is None:
                time.sleep(0.5)
                continue

            line = current_fp.readline()
            if not line:
                time.sleep(0.1)
                continue

            try:
                data = json.loads(line)
                thinkings = extract_thinking_texts(data)
                for think in thinkings:
                    if len(think) < 5:
                        continue
                    paragraphs = [p.strip() for p in think.split("\n\n") if p.strip()]
                    for p in paragraphs:
                        ja = translate_with_llm(client, p)
                        write_and_display(log_fp, ja)
            except json.JSONDecodeError:
                continue

def main():
    try:
        watch_sessions()
    except KeyboardInterrupt:
        print("\n監視を終了しました。")

if __name__ == "__main__":
    main()
名前はなんでもいいですが、「pi_translator.py」としています。
AGENTS.md
プロジェクトフォルダに以下の内容の「AGENTS.md」を配置。
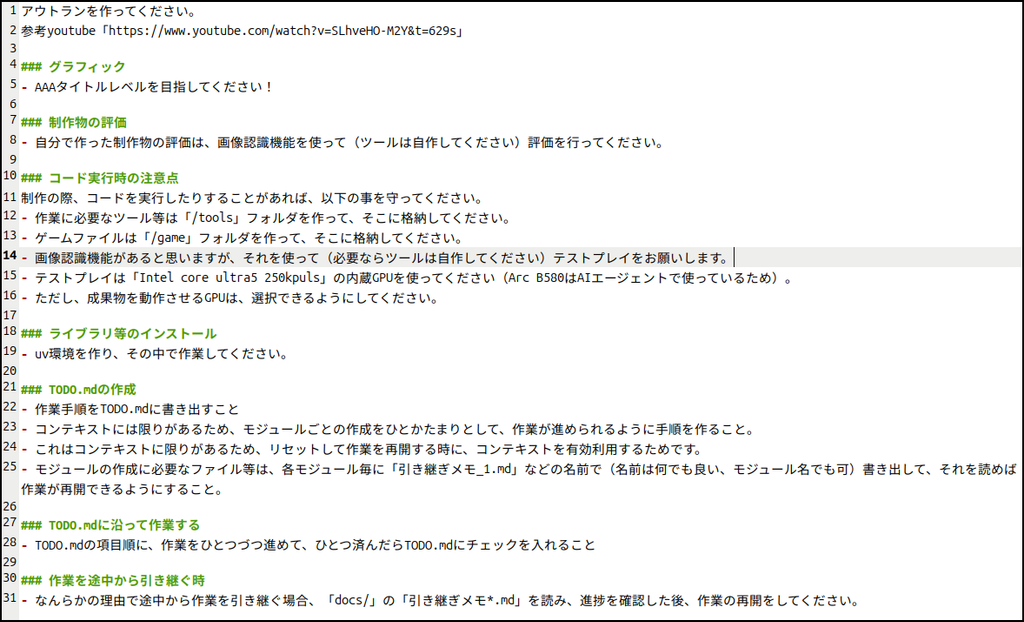
用意するファイルはこれのみ。
piを実行。
速度は・・・?
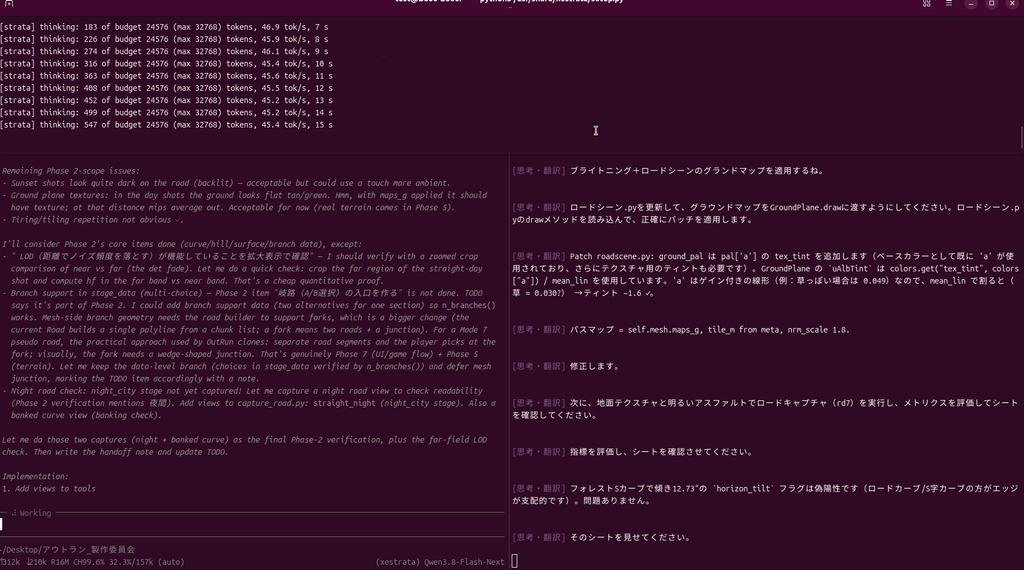
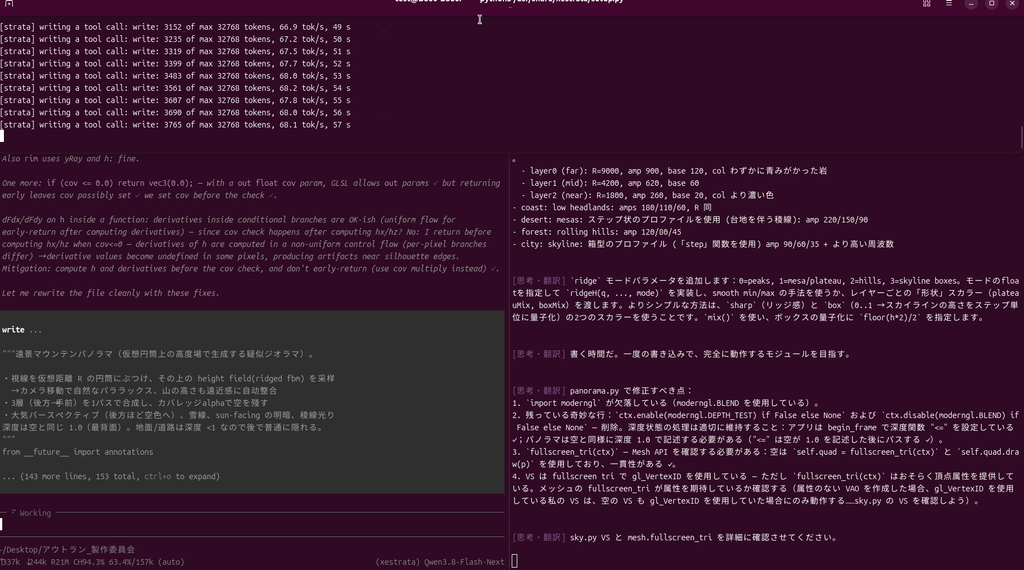
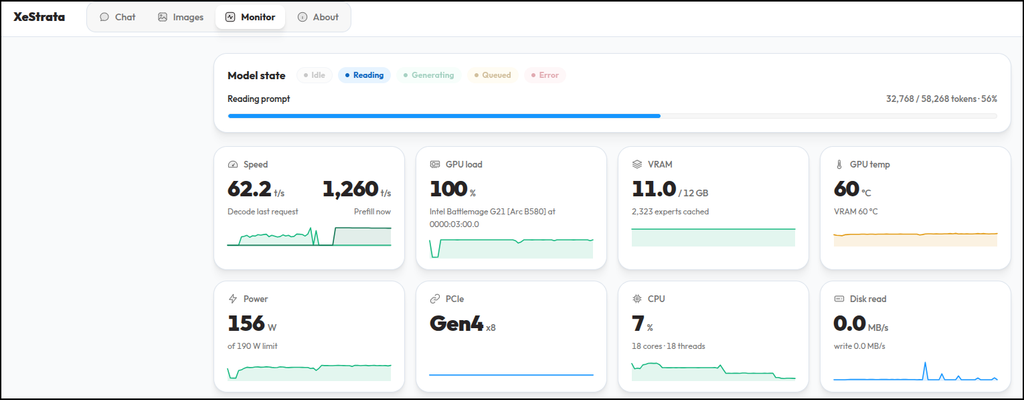
ただし、万能ではありません。
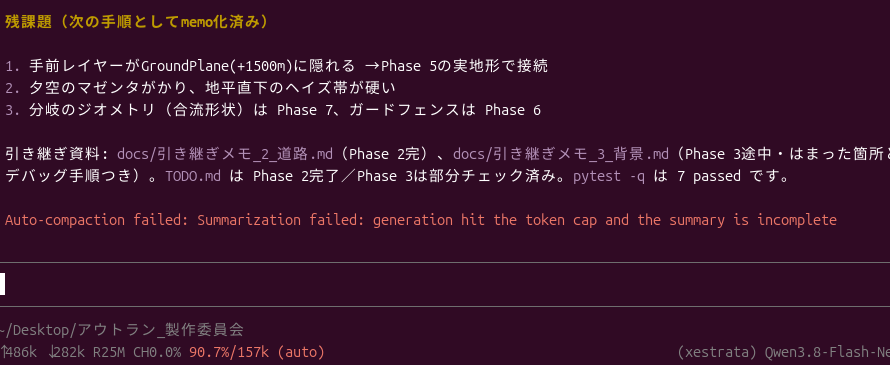
こういう時は、一度piを強制終了させて再起動。
作業再開
AGENTS.mdにも
### TODO.mdの作成
- 作業手順をTODO.mdに書き出すこと
- コンテキストには限りがあるため、モジュールごとの作成をひとかたまりとして、作業が進められるように手順を作ること。
- これはコンテキストに限りがあるため、リセットして作業を再開する時に、コンテキストを有効利用するためです。
- モジュールの作成に必要なファイル等は、各モジュール毎に「引き継ぎメモ_1.md」などの名前で(名前は何でも良い、モジュール名でも可)書き出して、それを読めば作業が再開できるようにすること。

### TODO.mdに沿って作業する
- TODO.mdの項目順に、作業をひとつづつ進めて、ひとつ済んだらTODO.mdにチェックを入れること

### 作業を途中から引き継ぐ時
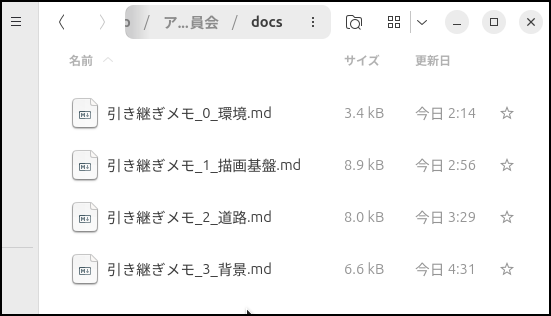
- なんらかの理由で途中から作業を引き継ぐ場合、「docs/」の「引き継ぎメモ*.md」を読み、進捗を確認した後、作業の再開をしてください。
との文言があるように、中断からの作業再開も視野に入れています。
丸一日かかって出来上がりました
けっこう良い雰囲気。
AAA 基準には未達(docs/評価レポート.md に差距理由を明記済み)。Phase 13(LOD/インスタンス化、CPU更新削減、植生LOD、車両作り込み)は未着手です。
と言っているのでAIエージェント的にはまだ改善フェーズが残っています。
私が「もう動くから」という理由で動画にしてしまったので、AIエージェントとしては不本意でしょう。
車両の中身も透けて見えてしまっています。
これから13フェーズとやらに着手してもらいますね。
ということで、今回はXeStrataとpiの改良についてでした。
2026/10/17の午前中には119800円だったと思ったのですが、速攻で売り切れたようですね・・・。


こちらが自分が購入したB580ですが、2026/10/18現在、やはり売り切れています。


一応、こちらは今も売られています。が、おそらく海外からの取り寄せです。


コメント