Amazonのアソシエイトとして、当ブログは適格販売により収入を得ています。
記事の内容は以下のシステムでテストされています。
Ubuntu26.04.1LTS
Core Ultra5 250K Puls
メインメモリ96GB(4800MT/s)
今回はIntel Core Ultra5 250K PulsのPコアとEコアを使って、llama.cppを動かしていきます。
単純に、「全てのコアをフルで動かせば推論が速くなる」というわけではないことがわかりました。
モデルは「gpt-oss-20b」を使っています。
本当は最近話題の「Qwen3.8-27B」を使いたかったのですが、
遅すぎて差が分かりにくかったので、速度差のわかりやすいモデルを使っています。
それではやっていきましょう。
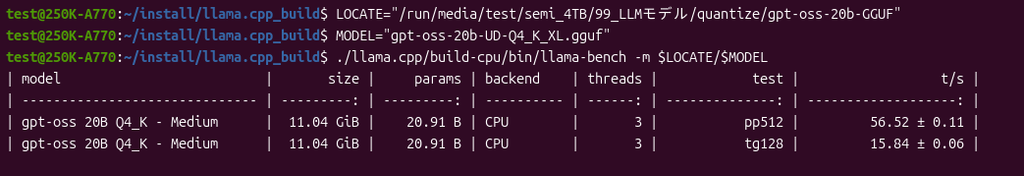
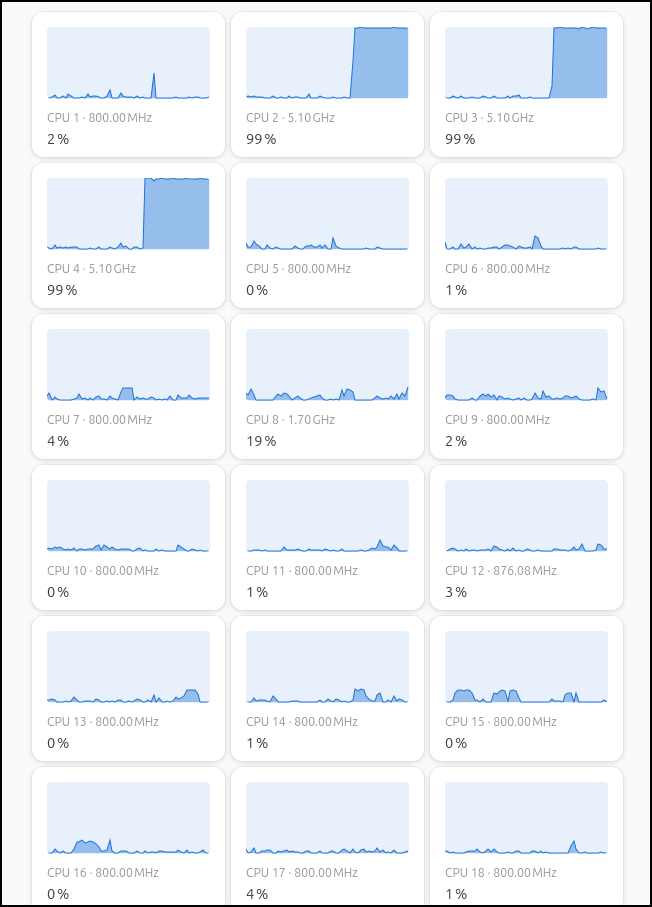
llama-benchで測定
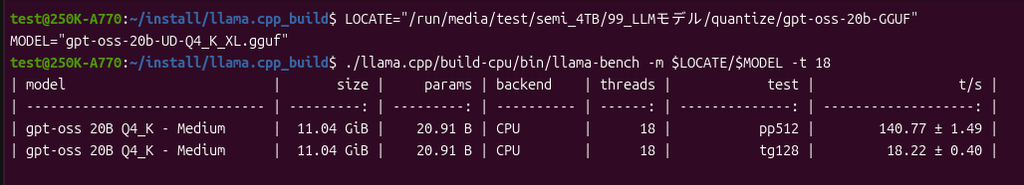
次はPコアとEコアで分けてベンチ
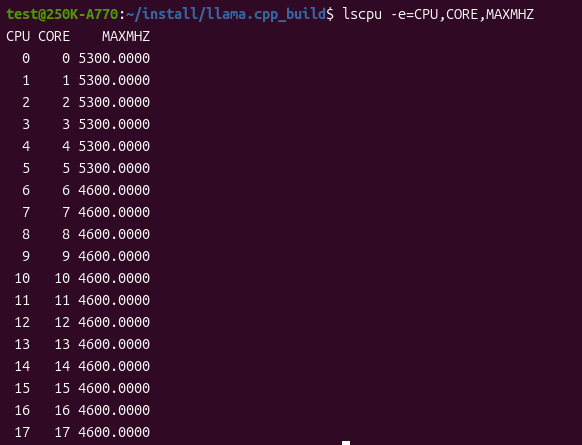
次のコマンドで、CPUコアの割当番号を見つけます。
lscpu -e=CPU,CORE,MAXMHZ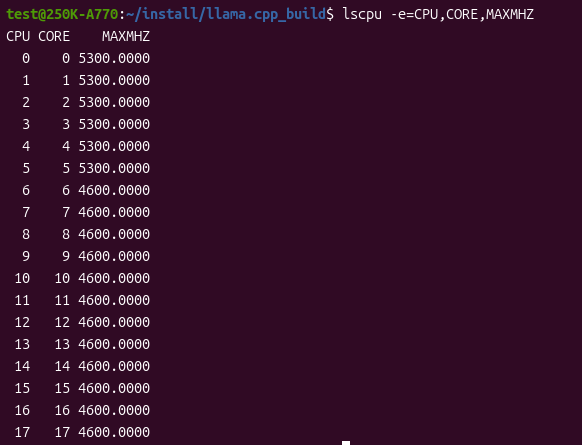
taskset -c 0-5 ./llama.cpp/build-cpu/bin/llama-bench -m $LOCATE/$MODEL -t 6上のコマンドで、Pコアのみでのベンチ開始。
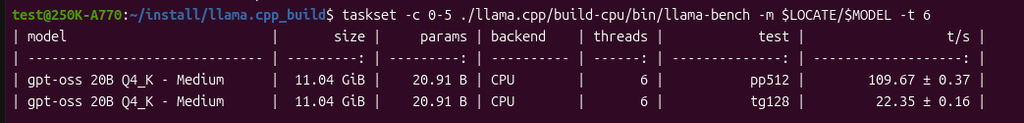
次はEコアのみ。
taskset -c 6-17 ./llama.cpp/build-cpu/bin/llama-bench -m $LOCATE/$MODEL -t 12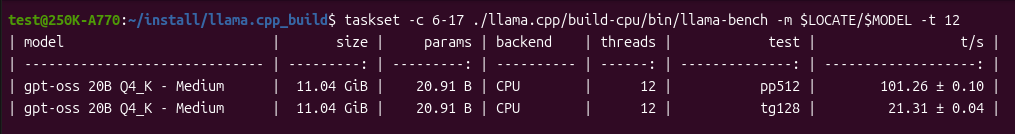
プリフィルと推論のいいとこ取りをしてみよう
コアがたくさんになると、プリフィル(プロンプト処理)が速くなり、PコアとEコアを跨ぐ処理をさせるとデコード(テキスト生成)が遅くなるようです。
次はいいとこ取りをしてみましょう。
ただし、ベンチマークツールでは、プリフィルとデコードでコアの割当を変更するオプションは選択できませんでした。
なので、普通にチャットする時のように「llama-server」で起動します。
「-t 6 -Cr 0-5」や「-tb 18 -Crb 0-18」のように「-t(デコード)」「-tb(プリフィル)」で設定すれば、コアの割当はできますが、
LLMのトークン生成(メモリ帯域勝負)では、スレッドが実行中に別のコアへ移動してしまうと、それまでL1/L2キャッシュに載っていたデータが無駄になり(キャッシュミス)、速度低下やレイテンシの揺らぎが発生します。
とのこと(Gemini談)なので、
「–cpu-strict 1(テキスト生成)」と「–cpu-strict-batch 1(プロンプト処理)」のオプションを使えばキャッシュに乗ったデータを無駄にすることがないとのこと。
いざ実行
普通にチャットしたり、エージェントで使ったりする時のようにllama-serverで起動しますので、何か適当なプロンプトを考えなくてはなりません。
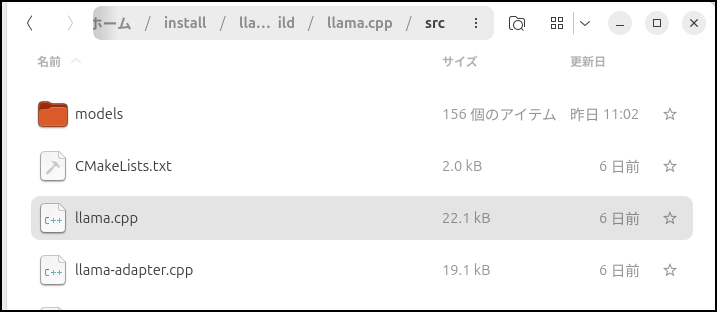
Geminiが言うには、llama.cppのソースコードを読ませれば良いとのこと。
なので、今回は以下のファイルをプロンプト処理用に使います。
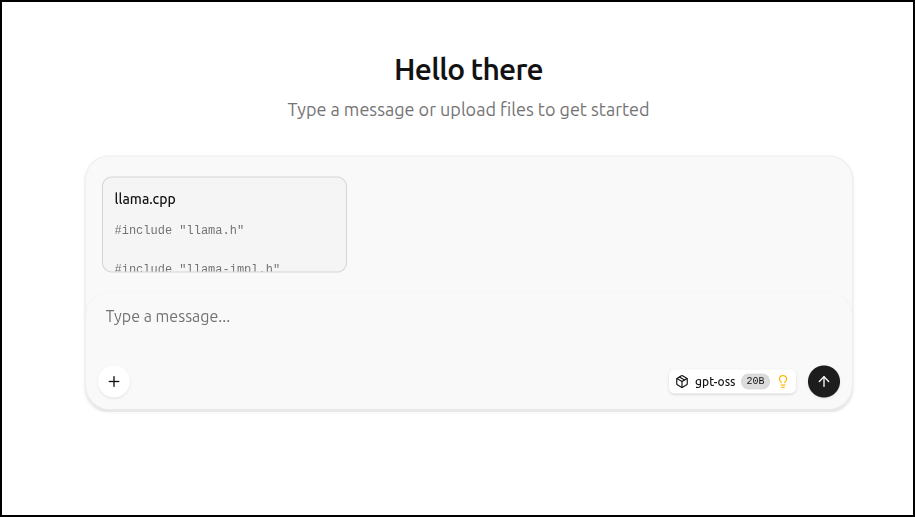
プロンプト処理は全コアで、デコードはPコアとEコアのパターンで分けます。
まずはPコア。
./llama.cpp/build-cpu/bin/llama-server -m $LOCATE/$MODEL \
    -t 6 -Cr 0-5 --cpu-strict 1 \
    -tb 18 -Crb 0-18 --cpu-strict-batch 1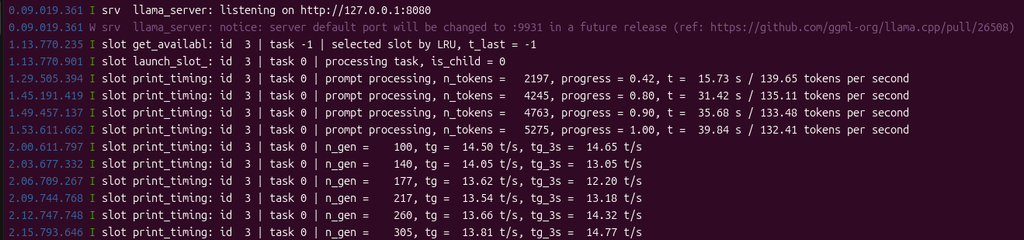
次はEコア。
./llama.cpp/build-cpu/bin/llama-server -m $LOCATE/$MODEL \
    -t 12 -Cr 6-17 --cpu-strict 1 \
    -tb 18 -Crb 0-18 --cpu-strict-batch 1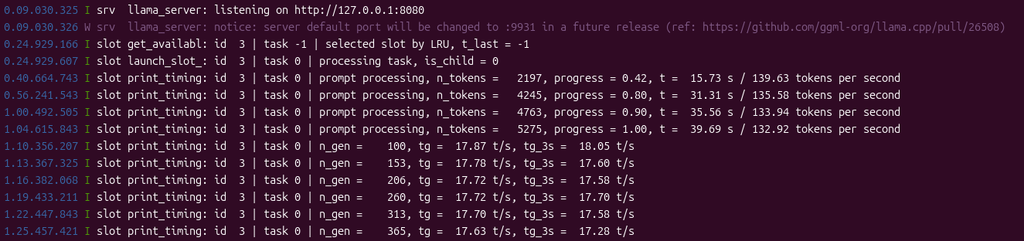
最後に
今回の記事では「gpt-oss-20b」を使いましたが、「gemma-4-26B-A4B」でも同じ傾向でした。
今のところプロンプト処理は全コア、デコードはEコアで動かした方が良さそうです。
今回は以上です。
コメント