Amazonのアソシエイトとして、当ブログは適格販売により収入を得ています。
記事の内容は以下のシステムでテストされています。
Ubuntu26.04.1LTS
Intel Core Ultra5 250K Plus
メインメモリ96GB(4800MT/s)
Intel Arc A770(16GB)
以前の記事「llama.cppをGUI化(Ubuntu編)」でllama.cppをGUI化したという記事を書きました。
この時に紹介した自作ツールが「simple-llama-studio」だったわけですが、このAI界隈は進化が速く、このツールでは対応しきれていない部分が出てきていました。
今回は、使っていない機能の削除、必要と思われるオプションの追加、Intel Arc用にsyclバックエンドの追加と大幅にリニューアルしました。
それではやっていきましょう。
とはいっても・・・
大筋で使い方は変わっていません。
仮想環境はuvを使っています。
uvの導入方法はこちらの記事を参考に。
以下の導入スクリプトもsycl対応とビルドスクリプトの変更くらいです。
#!/bin/bash

sudo apt install git

cd ~
mkdir -p install
cd install

# simple-llama-studioをダウンロード
git clone https://github.com/toaru-ubuntu/simple-llama-studio.git
cd simple-llama-studio

# uv環境を作ります
uv venv .venv --python 3.12
source .venv/bin/activate

# simple-llama-studioを動かすのに必要なライブラリ等
uv pip install huggingface_hub gradio pyyaml

# llama.cppのダウンロード
sudo apt install -y git cmake g++ libcurlpp-dev
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp

#CPU用ビルド
mkdir build-cpu
cmake -B build-cpu \
  -DCMAKE_BUILD_RPATH='$ORIGIN;$ORIGIN/../lib'
cmake --build build-cpu --config Release -j$(nproc)

#vulkanビルド
sudo apt install -y libvulkan-dev glslc spirv-headers
cmake -B build-vulkan \
  -DGGML_VULKAN=ON \
  -DCMAKE_BUILD_RPATH='$ORIGIN;$ORIGIN/../lib'
cmake --build build-vulkan --config Release -j$(nproc)

#sycl用ビルド
mkdir build-sycl
source /opt/intel/oneapi/setvars.sh
cmake -B build-sycl \
  -DGGML_SYCL=ON \
  -DCMAKE_C_COMPILER=icx \
  -DCMAKE_CXX_COMPILER=icpx \
  -DLLAMA_OPENSSL=OFF \
  -DCMAKE_BUILD_RPATH='$ORIGIN;$ORIGIN/../lib'
time cmake --build build-sycl --config Release -j$(nproc)

# ggufの量子化に必要なライブラリ等
# ですが、このツールでは量子化はもうできません。以下は必要ないかも。
uv pip install -r ./requirements.txt --index-strategy unsafe-best-match
「-DCMAKE_BUILD_RPATH=’$ORIGIN;$ORIGIN/../lib’」を付けないと、ライブラリが足りないとかでエラーが出るようです。
あとはIntel Arc用に「SYCLビルド」も追加しました。
最近のモデルはvulkanよりSYCLの方が速い場合も増えてきたようで・・・。
ダウンロードUIの変更
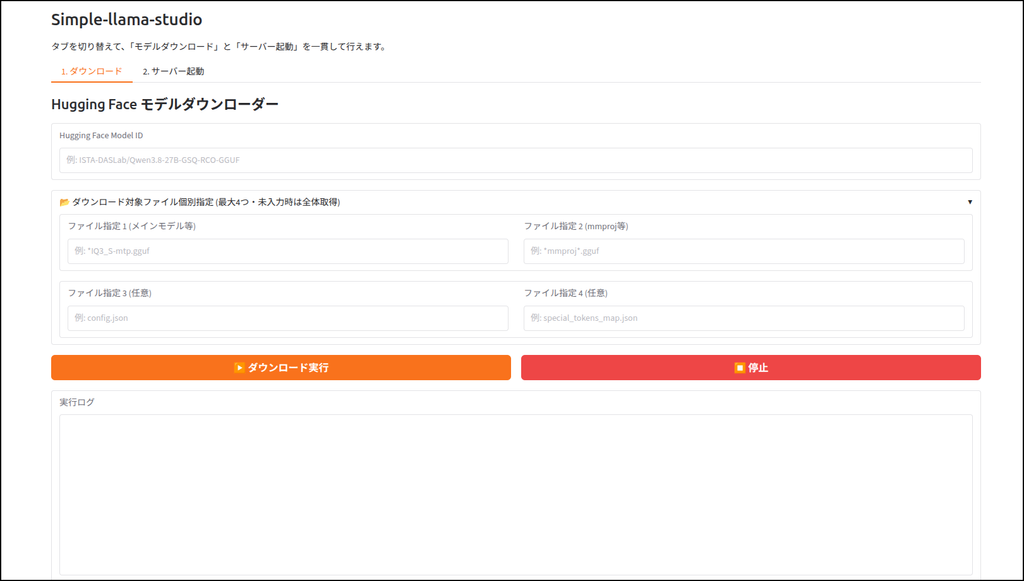
今まであった、
- safetensors→ggufの変換
- ggufの量子化
- mmprojの抽出
の3つの機能をオミットしました。
safetensorsは容量が大きすぎる場面が増えてきて、直接ggufをダウンロードする場合がほとんどです。
mmporjもモデルと同時に公開されるのが通常となりました。
ということで、これらの機能は削除。
代わりにダウンロードを多少便利にしました。
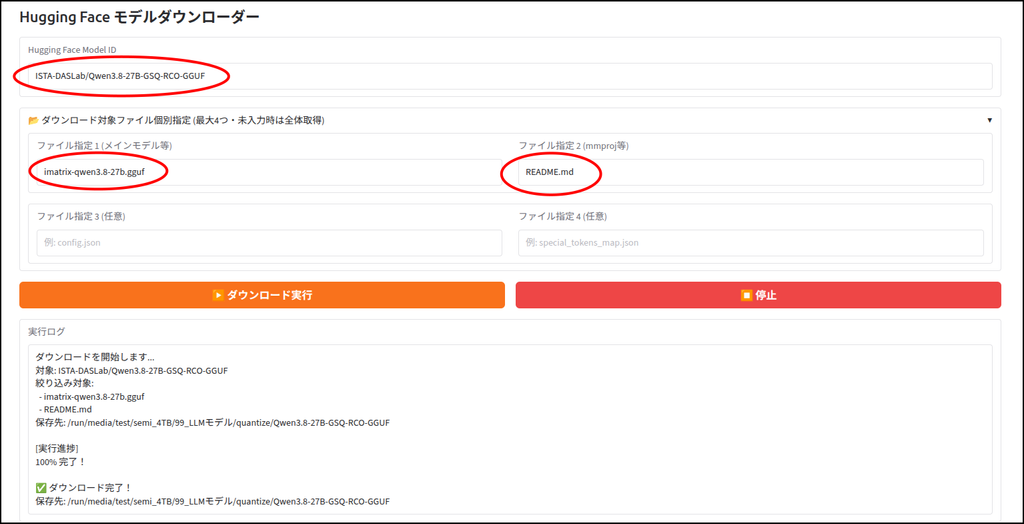
safetensorsの時はフォルダの中身ごとダウンロードしていましたが、ggufやmmprojの場合はファイルを指定してダウンロードすることがほとんどです。
なので、ダウンロードしたいファイルを入力することでピンポイントで落とすことができるようになりました。
サーバーUIの変更
こちらは大幅に変更しています。
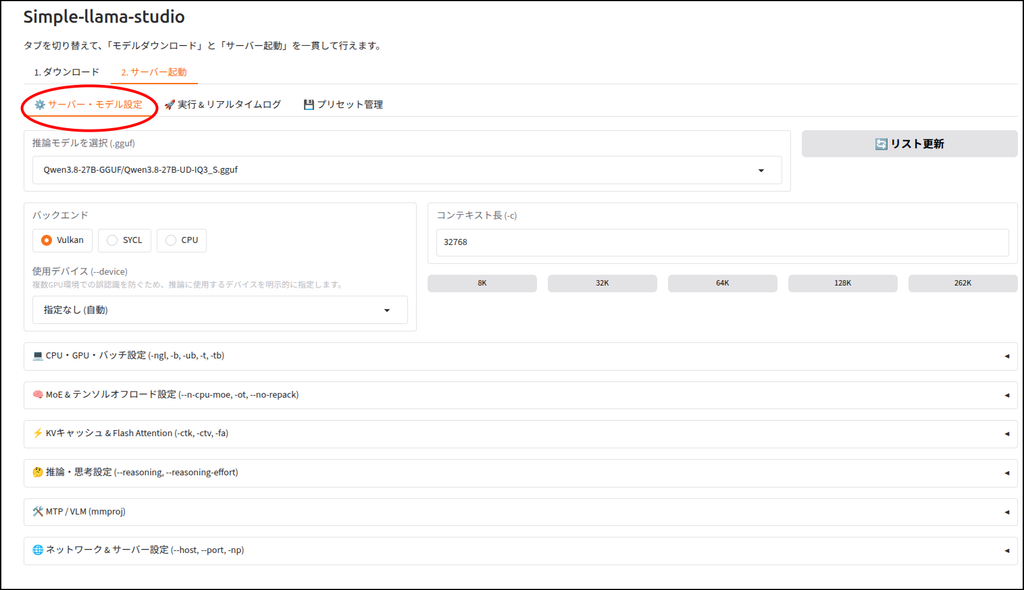
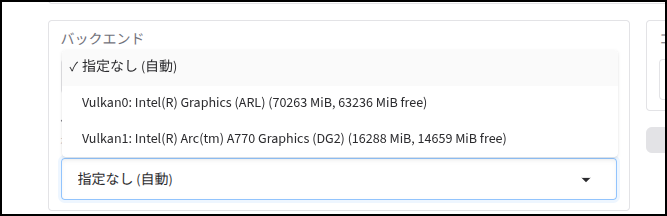
ただし、UIではマルチGPUには対応していません。
llama.cpp自体は対応していますが、自分がマルチGPU環境を持っていないので、検証することができません。
もし、ブルジョワにもマルチGPU環境になりましたら、実装します。
あと、とても忘れがちなのですが
SYCLバックエンドで動かす場合、このツールを起動する前に
source /opt/intel/oneapi/setvars.sh
を実行するのを忘れないようにしてください。
当然、oneAPIベースツールキットが必要です。
こちらの記事を参考にしてください。
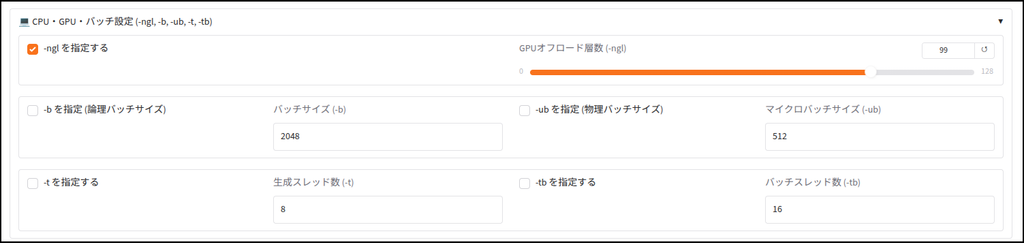
- -ngl
- LLMを何層GPUに乗せるかを指定します。
- チェックを外すとllama.cppの自動設定になります。
- -b,-ub
- プロンプト処理の一括処理数。
- ごめんなさい、よくわかりません。
- -t,-tb
- CPUで処理する時に指定するスレッド数。
- -tが推論、-tbがプロンプト処理。
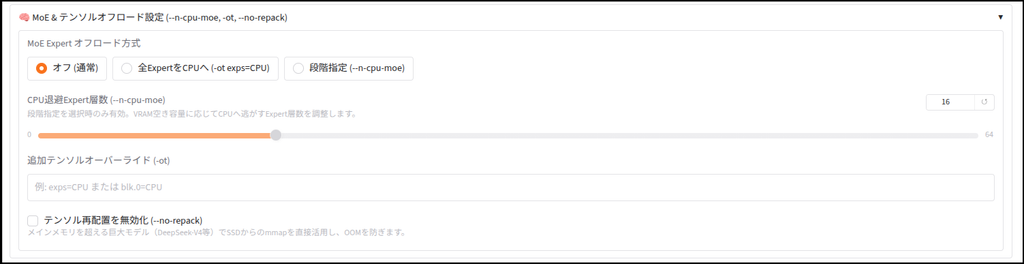
前段で「-ngl」を「99」などに設定した場合の追加設定。
VRAMに乗り切らなかった層を、メインメモリ側にどのくらい処理させるか。
一番下の「テンソル再配置を無効化」は、VRAMにもメインメモリにも乗り切らない場合にチェックを入れることで、SSDなどからロードすることができるようになります。
こちらで記事にしています。
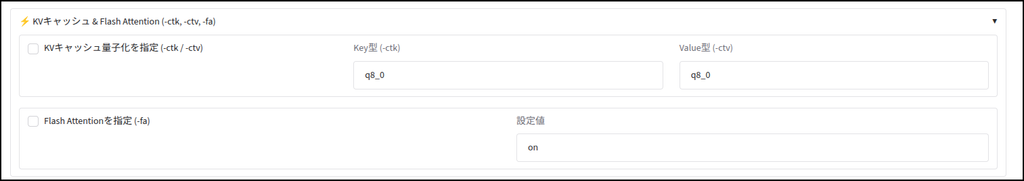
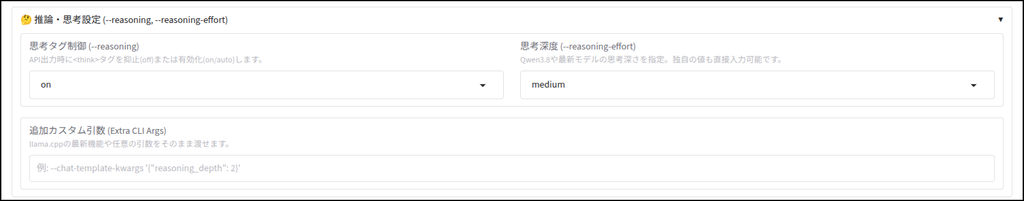
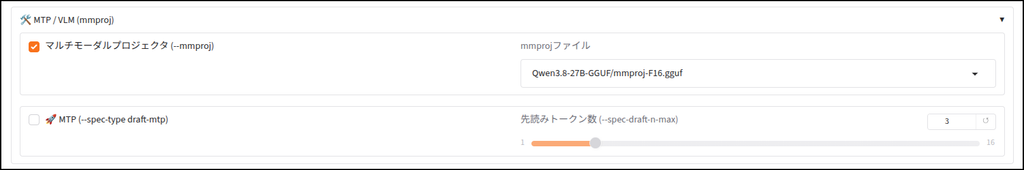
マルチモーダルプロジェクタに関しては、推論モデルとは別で用意されることが多いため、別個で指定するようにしています。
が、MTPは推論モデルに統合される場合が増えてきたため、別個でモデル指定はできないようにしました。gemma-4使いの人には申し訳ありません。
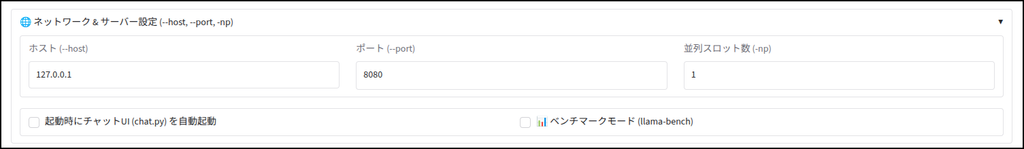
主にAIエージェント用です。
サブエージェントで使うための並列スロットも指定できるようにしています。
llama.cppでは4並列が最大だったような・・・(間違っていたらごめんなさい)。
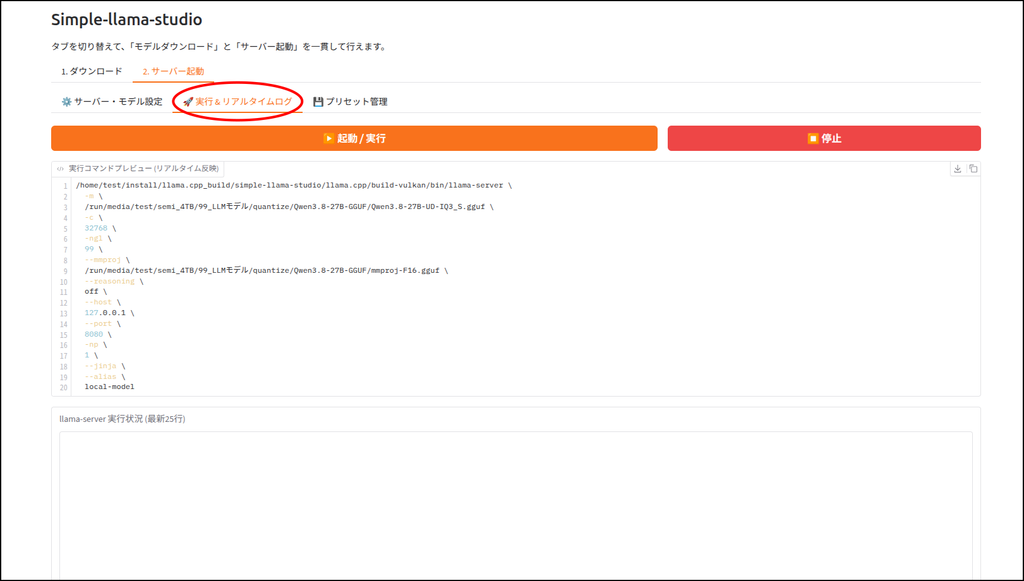
前段で設定した内容を実行するタブ。
一応llama.cppで直接実行する時の為のコマンドも出力しています。
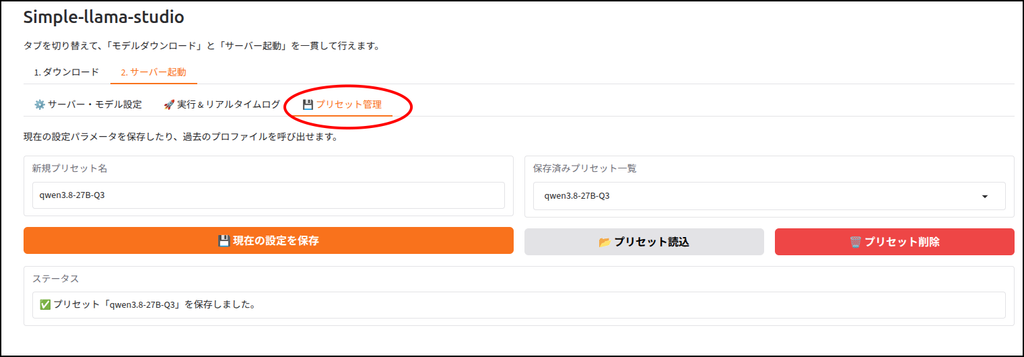
最後に
頻繁にリリースされるLLMは、推論サーバーが対応しないと動きません。
自分の場合の推論サーバーはllama.cppが主なので、このUIを用意したわけです。
LMStudioやOllamaも後ろではllama.cppが動いていますが、即応性という点ではllama.cppに一歩劣ります。
もし、試してみたいモデルがあった場合、使ってみて下さい。
その場合は当然llama.cppをgit pullで更新したあと、それぞれのバックエンドで再ビルドが必要です。
最近のグラフィックスボードって値段が上がりすぎです。
あんまり変化していないのって以下くらい?
まぁ、高額なんでオススメはしないです。
あとIntel Arcは、使いこなすのが難しいです。


コメント